AI 正在改變藥物研發、蛋白質工程與農業生物學。從大型語言模型到生成式機器學習,越來越多的演算法正在幫助研究人員預測蛋白結構、設計抗體序列、優化基因編輯工具,甚至探索全新的功能性分子。但在生命科學研究中,一個關鍵問題始終存在:AI 可以提出設計方案,但它無法取代濕實驗室(Wet Lab)完成真實驗證。
對於 AI/ML 驅動的生物研發而言,真正決定模型價值的,不只是「算得出來」,更是「做得出來、測試得準、學得回去」。這正是合成 DNA 與濕實驗室驗證的重要意義。
為什麼 AI/ML 模型必須經過濕實驗室驗證?
在計算環境中表現優異的模型,不一定能在真實實驗條件下同樣有效。尤其在蛋白質工程、抗體發現和基因編輯等複雜場景中,模型往往面臨多重挑戰:
- 訓練資料並不完美: AI 模型常常需要基於有限或不完整的資料集進行複雜外推。這可能導致模型過度關注某一個指標(例如結合親和力),卻忽略了穩定性、溶解性、表達量、可開發性等同樣關鍵的因素。一個看似「計算評分很高」的候選分子,進入實驗室後可能出現表達困難、折疊異常或穩定性不足等問題。
- 生物系統存在複雜的湧現行為: 蛋白質功能受到分子內和分子間相互作用的共同影響。某些突變組合可能帶來意料之外的結果,例如蛋白質錯誤折疊、自聚集,或產生影響功能表現的非預期修飾。這些複雜現象,往往很難完全從訓練資料中學習。
- 模型具有背景依賴性: 模型在某一種實驗背景下訓練所得到的規律,不一定能直接遷移到另一個系統。例如,同一個設計在大腸桿菌、HEK293 或 CHO 細胞中表達,可能面對完全不同的生物學限制。
因此,濕實驗室驗證並不是 AI 研發流程中的「最後一步」,而是推動模型持續優化的關鍵環節。
從「預測」到「學習」:設計—建構—測驗—學習循環
在 AI 驅動的合成生物學研究中,一個高效率的研發流程通常包括四個階段(Design-Build-Test-Learn,DBTL):
- 設計(Design): 使用生成式 AI 設計新型序列、蛋白質或功能組件,並透過預測模型和計算篩選初步評估候選方案。
- 建構(Build): 將數位化設計轉化為實體 DNA,包括合成目標序列、選殖(克隆)到載體中,並表達目標分子。
- 測試(Test): 在濕實驗室中對候選分子進行功能表徵,例如結合能力、免疫原性、可開發性、穩定性等分析。
- 學習(Learn): 將實驗結果回饋給 AI/ML 模型,作為新的訓練數據,用於模型再訓練和下一輪設計優化。
這個循環使 AI 模型不再停留在靜態預測層面,而是不斷吸收真實實驗數據,逐步提升預測品質和研發效率。
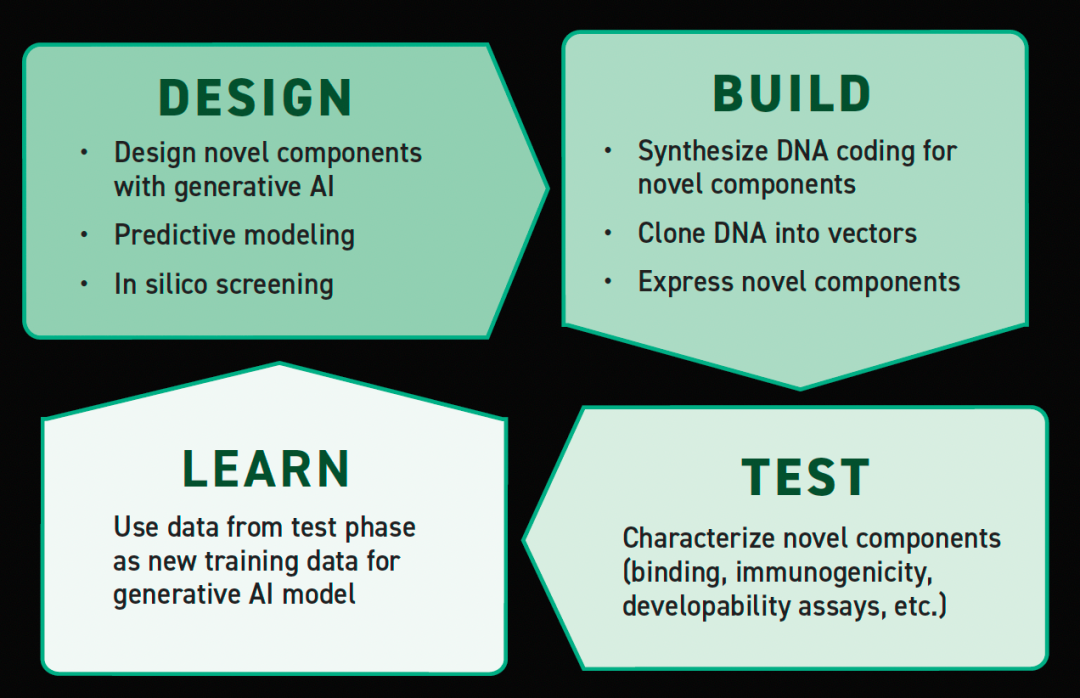
圖 1:Design-Build-Test-Learn 循環 濕實驗室測試不僅驗證模型,也為模型再訓練提供新數據。
合成 DNA:連結 AI 設計與真實實驗的關鍵橋樑
AI 產生的是數位序列,而實驗室需要的是高品質、可驗證的實體分子。這中間最關鍵的一步,就是將電腦中的精準設計,準確轉化為真實 DNA。
傳統 DNA 合成方式常依賴較短片段的拼接,過程中可能引入錯誤,導致最終序列與 AI 原始設計不完全一致。一旦合成環節出現偏差,後續實驗數據可能無法真實反映模型設計的效果,甚至誤導模型再訓練。
Twist Bioscience 的矽基 DNA 合成平台,能夠幫助研究人員更準確、更有效率地將 AI 設計轉化為實體 DNA,從而支持高保真(high fidelity)驗證數據的產生。對於 AI/ML 研發而言,高品質合成 DNA 的價值不僅在於「做出序列」,更在於確保實驗數據能夠真實反映模型意圖,避免低品質數據影響模型性能。
Lab-in-the-loop:讓 AI 抗體設計進入主動學習時代
在抗體開發中,「Lab-in-the-loop」(實驗室迴圈)正成為一個重要的新典範。在這個閉環流程中:
- 生成式機器學習模型首先設計抗體變體。
- 預測模型對這些候選序列進行排序。
- 透過高品質 DNA 合成將候選序列轉化為實體分子,並在體外進行功能表徵。
- 實驗數據被重新用於模型訓練,推動下一輪設計優化。
在相關案例中,研究人員透過四輪迭代,產生了 1,800 個獨特抗體變體,覆蓋四種標靶抗原,並篩選出多個結合親和力提升 10 倍至 100 倍的抗體候選物。這項成果背後的關鍵之一,正是能夠準確合成由機器學習設計的抗體變體,並將真實實驗數據持續回饋給模型。
當 AI 設計、DNA 合成、實驗驗證和模型再訓練形成閉環,抗體發現便從一次性的預測任務,轉變為持續優化的主動學習系統。
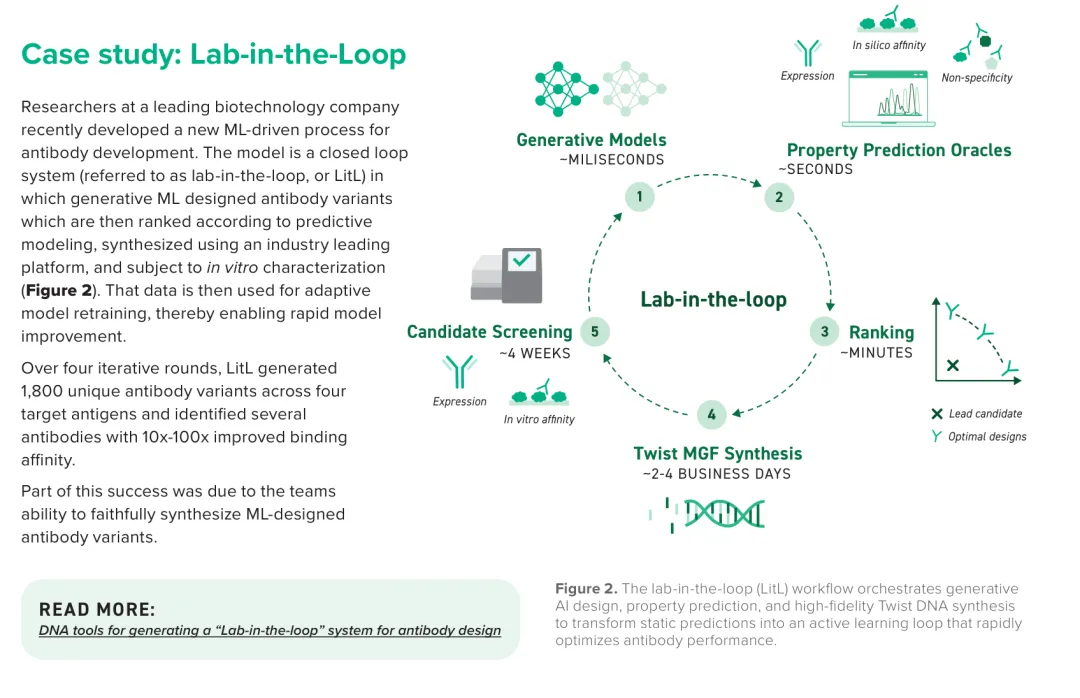
圖 2:Lab-in-the-loop 案例與流程圖 生成式模型、屬性預測、排序、Twist MGF 合成與候選物篩選共同構成主動學習閉環。
Twist 如何支持 AI 驅動的生物研發?
導向 AI/ML 研究,Twist 提供從合成 DNA 到抗體發現和數據交付的一系列解決方案,幫助研究人員將數位設計快速推進到實驗驗證階段。
合成 DNA 解決方案
Twist 的合成 DNA 產品可支援多種 AI 研發場景,包括:
- 基因片段(Gene Fragments): 支援快速「設計—建構—測試」迭代,幫助研究人員更有效率地驗證候選序列。
- 基因池(Gene Pools): 支援大規模序列多樣性探索,可用於複雜文庫驗證。
- 多重基因片段文庫 (Multiplexed Gene Fragments): 可用於覆蓋抗體 CDR 區或蛋白質結構域,適合大規模平行篩選。
- 基因突變體文庫(Variant Libraries): 支持位點飽和或組合變異體設計,幫助研究人員系統探索蛋白質親和力與功能空間。
- 寡核苷酸池 (Oligo Pools) : 支援高通量功能研究,可並行評估大量序列變異。
這些工具能夠幫助 AI 研究團隊更快建立驗證資料集,並讓模型預測在真實實驗中接受檢驗。
從序列到資料:端對端抗體解決方案
對於運算能力強、但濕實驗室基礎設施有限的團隊而言,從 AI 設計走向實驗數據往往是一大挑戰。Twist 可提供端對端抗體解決方案,幫助研究人員完成從序列生成、候選物表達、結合評估、可開發性分析到標準化資料交付的完整流程。
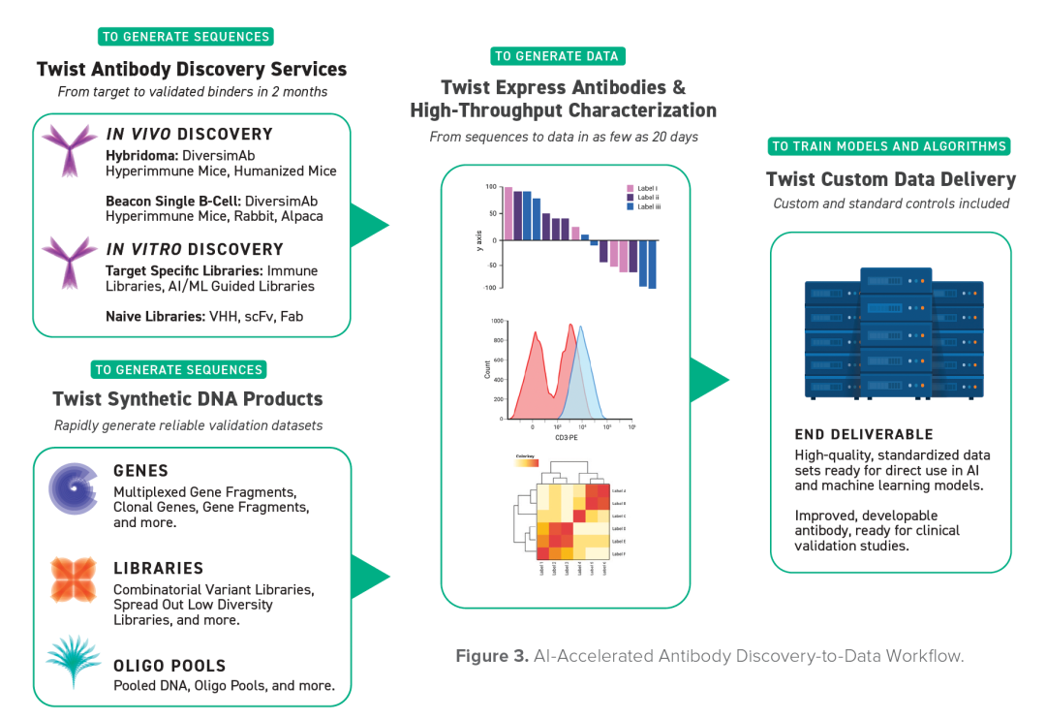
圖 3:AI 加速抗體發現到數據工作流程 從序列生成、實驗表徵,到可直接用於 AI/ML 模型的標準化資料交付。
Twist 端對端抗體解決方案核心能力:
- 抗體生產: 支持 VHH、scFv 或 IgG 等格式的高通量表達,並可在 HEK 或 CHO 細胞中完成表達與純化。
- 結合評估: 產生可用於模型再訓練的標準化數據,包括動力學、親和力和表位分析(Epitope Binning)等資訊。
- 客製化表徵: 根據專案需求評估生物活性和安全性特徵,例如內化、免疫原性、細胞毒性和目標特異性交叉反應等。
- 可開發性分析: 透過自相互作用、單體純度和熱穩定性等高解析度數據,幫助更早識別具有開發潛力的候選物。
- 客製化資料交付: 提供機器可讀、統一且可對應的資料格式,方便與 AI 平台或 LIMS(實驗室資訊管理系統)整合。
透過這些能力,Twist 幫助研究人員縮短從 AI 設計到模型可用資料之間的距離,讓濕實驗室驗證真正成為 AI 研發循環的一部分。
AI 的未來,需要濕實驗室作為支點
AI/ML 正在為生命科學帶來前所未有的想像空間。但在合成生物學、抗體發現、蛋白質工程和農業生物學等領域,模型的真正價值最終仍要在實驗中被驗證。高品質合成 DNA、可靠的濕實驗室表徵和標準化數據交付,是連接 AI 預測與真實生物功能的關鍵橋樑。
當數位設計能夠被準確地構建,當實驗結果能夠被高品質回饋,當模型能夠在真實數據中持續學習,AI 驅動的生物研發才有可能真正加速。
Twist Bioscience 致力於幫助研究人員建造這座從 AI 設計通往濕實驗室驗證的橋樑,推動下一代藥物發現、抗體工程、功能基因組學和農業生物學創新。
準備好搭建通往濕實驗室的橋樑了嗎?
我們精心為您準備了系列研討會與案例研究內容,分享全球領先實驗室的 AI 科研實踐,為您提供可落地的思路與方法。點擊下方的圖片即可獲得「AI Researcher’s Guide to DNA」電子文檔,直達「系列研討會及案例研究」。
如有任何問題,歡迎洽詢 業務專員 或 加入 ABreal 倍思特生技 Line@: @abreal